深入智能体循环:AI 编程智能体、Claude Code 与重塑 2026 年软件工程的架构
内容简介:深入解析 Claude Code 和 OpenAI Codex 等 AI 编程智能体的底层工作机制,涵盖智能体循环架构、上下文窗口管理、子智能体编排、CI/CD 集成,以及 Uber 有 25% 的代码提交由智能体完成这一里程碑对 2026 年软件工程走向的启示。
改变一切的数字
百分之二十五。
2026 年第一季度,Uber 全部代码提交中有四分之一是通过 Claude Code 完成的。这不是试点项目,也不是黑客马拉松上的实验,而是进入正式生产流程的常规提交——发生在全球最复杂、服务数量众多、技术栈多元的软件工程组织之一。
Uber 的工程团队在短短几个月内就用完了全年 AI 预算。据报道,Anthropic 有望在 2026 年第二季度实现 109 亿美元营收,这可能是该公司有史以来首个盈利季度,增长主要由企业客户使用编程智能体所推动。SpaceX 于 2026 年 5 月提交的 S-1 文件还低调披露,Anthropic 已签署一份合同:截至 2029 年 5 月,每月支付 12.5 亿美元,购买 Colossus I 和 Colossus II 的算力容量,主要用于推理,而非模型训练。
最后这个数字非同寻常。一家公司每月仅为向用户提供响应就花费超过 10 亿美元,说明这项技术已经从“前景可期的技术”跨越到了关键基础设施。
对于开发者来说,采用率与基础设施投入同时攀升,传递出一个强烈信号:AI 编程智能体不是未来,而是当下。真正理解它们如何工作——深入到架构层面——的工程团队,才能从中获得远超平均水平的价值。
本文将带你深入梳理这套架构。
AI 编程智能体究竟有何不同
深入讨论之前,我们先明确一个概念边界:什么是 AI 编程智能体,它又与 AI 编程助手有何区别?
编程助手(例如早期版本的 Copilot,或用于编程场景的 ChatGPT)遵循严格的请求—响应模式:你给出提示,它返回文本。开启新会话后,它不会记得之前的交流;它只能看到你粘贴到窗口里的内容;它不能运行代码、读取文件系统,也无法检查自己的建议能否编译通过。从根本上说,它就是一个非常聪明的自动补全工具。
编程智能体则完全是另一回事。两者的关键差异在于:工具使用 + 自主循环。
智能体可以:
- 读取你的实际文件,而不只是你粘贴的一小段代码;
- 执行Shell 命令、测试套件和构建系统;
- 搜索网络与文档,获取实时信息;
- 编辑文件、暂存变更并创建提交;
- 在无需等待你确认的情况下,将以上操作连续执行数十步;
- 某一步失败时,像人类工程师一样调整方向。
这里发生的观念转变,是从“能回答代码问题的 AI”转向“能承担工程工作的 AI”。这会深刻改变你与它的交互方式、衡量其产出的标准,以及管理成本的方法。
深入智能体循环:核心架构
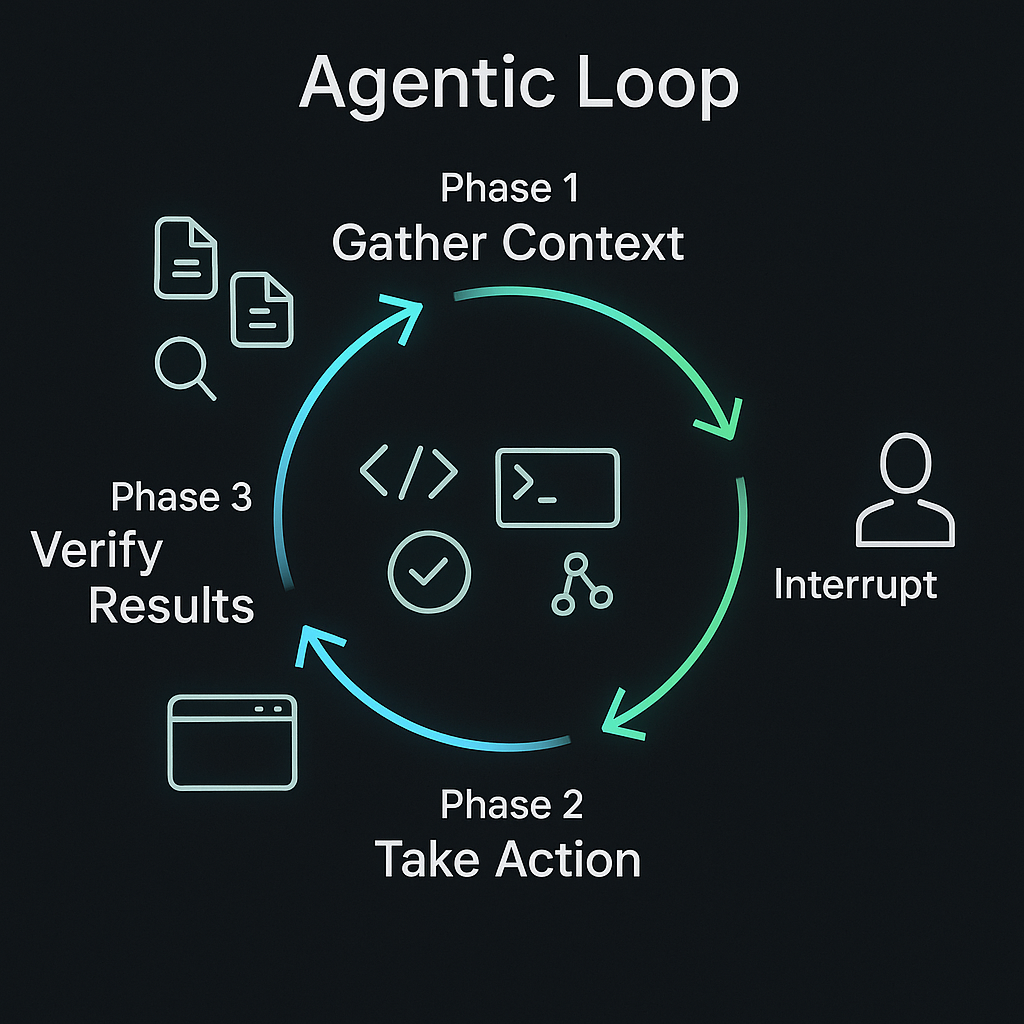
Claude Code(以及类似的 OpenAI Codex)的核心运行机制,由 Anthropic 工程团队称为智能体循环(agentic loop)的流程所驱动。这是一个由三个阶段组成的循环,会不断重复,直到任务完成或你主动中断。
阶段一:收集上下文
动手改代码之前,Claude 首先会为你的代码库建立一个整体认知模型。这个过程包括:
- 读取
CLAUDE.md和MEMORY.md(持久化指令文件); - 遍历目录结构,了解项目布局;
- 使用 glob 和正则表达式查找与任务相关的文件;
- 查看 Git 历史,理解现有代码背后的意图;
- 获取你在提示中引用的文档网址。
这个阶段以只读工具调用为主。模型会将信息不断累积到上下文窗口中,建立自己的工作记忆。上下文窗口是一项至关重要的资源,我们稍后会深入讨论。
阶段二:采取行动
上下文足够后,Claude 就开始执行。具体操作取决于任务,可能包括:
- 编写或编辑源文件;
- 运行测试套件,建立基线;
- 进行有针对性的修改;
- 运行构建命令,检查编译错误;
- 使用
git diff检查变更内容。
这些操作并非按照预先写死的静态顺序执行。模型会根据上一步的结果,决定下一步要做什么。测试失败的输出会反馈到循环中,引发新一轮的读取、编辑和重新运行。
阶段三:验证结果
验证,往往是顺利使用 Claude Code 与令人沮丧地使用它之间的分水岭。如果你给出可验证的成功标准——例如“测试套件全部通过”“Lint 不产生任何警告”或“/health 返回 200”——Claude 就可以自主执行验证,并循环修复尚未解决的问题。
没有验证标准,智能体就像在盲飞。它给出的结果看上去正确,却未必真的正确;最终,你只能亲自充当唯一的反馈机制。
关键观点:智能体循环不是一条单向线性流水线,而是一种可以嵌套、分支和重试的控制流——就像工程师解决问题时的工作方式。你的职责是定义目标与验收标准,而不是规定每一个具体步骤。
工具生态:智能体如何操作代码库
智能体循环依靠一组工具运转,这些工具让模型具备了文本生成以外的行动能力。Claude Code 内置的工具类别大致如下:
| 类别 | 可实现的能力 |
|---|---|
| 文件操作 | 读取文件、编写或编辑代码、创建新文件、重命名和整理文件 |
| 搜索 | 按模式查找文件(glob)、通过正则表达式搜索内容、探索大型代码库 |
| 执行 | 运行 Shell 命令、启动开发服务器、调用测试运行器、使用 Git |
| 网络 | 搜索网页、获取 API 文档、实时查询错误信息 |
| 代码智能 | 编辑后查看类型错误和警告、跳转到定义、查找所有引用 |
除了核心循环,Claude Code 还支持一个扩展层:
- MCP(模型上下文协议)服务器——连接外部服务,例如数据库、问题跟踪器和可观测性平台;
- Skills(技能)——按需加载的自定义指令集,用于特定领域的工作流(类似宏);
- Hooks(钩子)——在特定工具调用前后运行的 Shell 脚本(例如每次写入文件后自动格式化);
- 子智能体——拥有独立上下文窗口、用于承接委派子任务的智能体(下文会详细介绍)。
这种设计理念是:Claude 的基础能力默认保持精简——它只能做工具明确允许的事;你可以根据需要,有选择地扩展能力。这既是产品设计决策,也是一种成本控制手段。
上下文窗口:最关键的工程约束
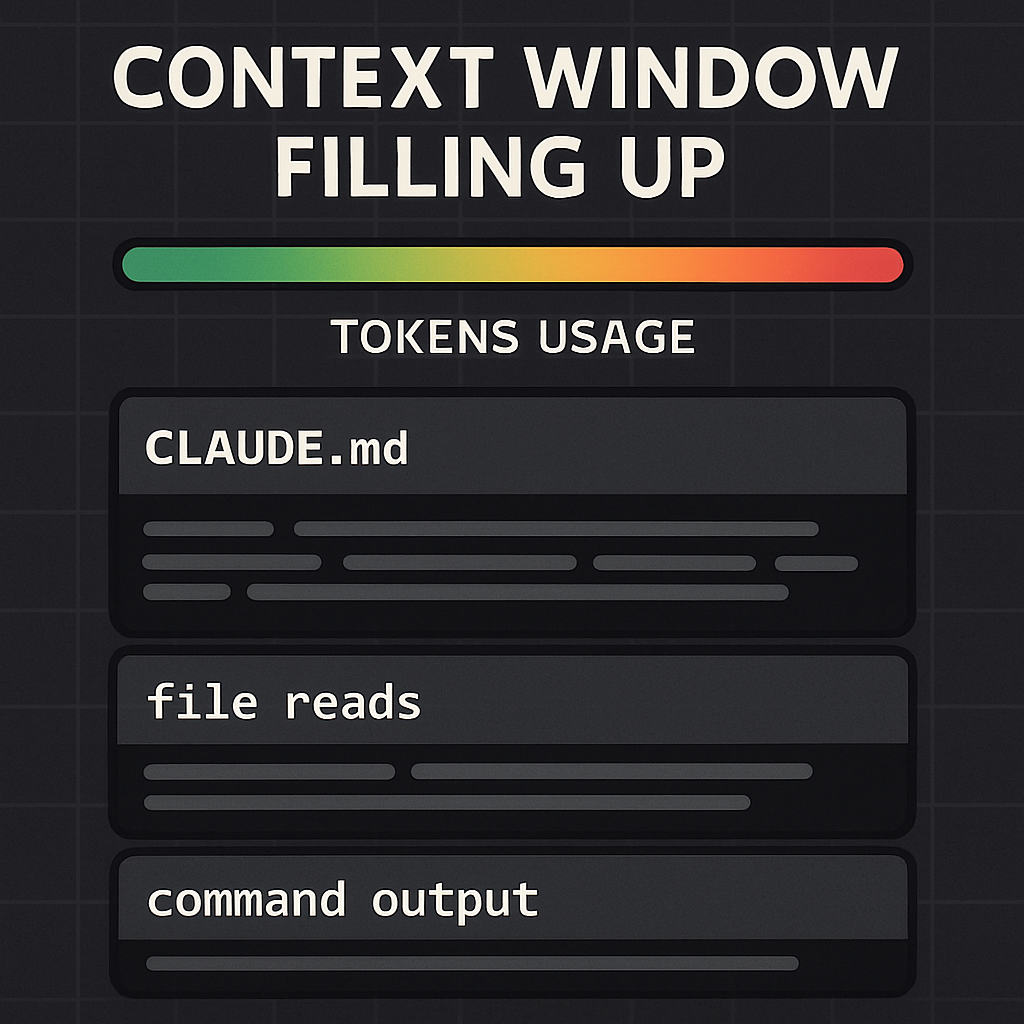
如果要问经验丰富的 Claude Code 用户有什么心得,他们多半会告诉你:上下文窗口是最宝贵的资源,而且消耗速度比你想象的快得多。
上下文窗口里装着所有内容:
- 你的初始提示;
- 助手的每一条回复;
- Claude 读取过的每个文件(完整内容);
- 每条 Shell 命令及其完整输出;
- 整段对话历史。
一次调试会话,如果读取了 10 个中等大小的源文件、运行三次测试套件,并查看了几个依赖库的实现细节,就可能轻轻松松消耗5 万到 10 万个 Token。随着上下文逐渐填满,模型性能会出现可衡量的下降:它开始记不住早先的指令、做出前后不一致的修改,甚至与之前的推理相矛盾。
上下文管理的实用策略
1. 不同任务使用全新会话。不要试图在同一会话里既重构模块,又实现新功能。重构留下的上下文噪声会影响后续功能开发。
2. 用子智能体做探索。如果需要 Claude 先研究代码库,再开始执行,就把探索工作交给 Explore 子智能体。它有自己的上下文,不会让搜索结果淹没主会话。
3. 让 CLAUDE.md 保持精简。这个文件会在每次会话开始时加载,每一行指令都会在每项任务中消耗 Token。Anthropic 团队的原则是:如果删掉某一行也不会导致 Claude 犯错,那就删掉它。
4. 精确限定文件范围。不要只让 Claude“看看整个认证模块”,而应直接指出具体文件,例如 @src/auth/token_refresh.py。
5. 持续关注上下文用量。安装自定义状态栏(Claude Code 原生支持此功能),实时追踪 Token 消耗,就像为会话装上燃油表。
CLAUDE.md:新一代开发者配置基元
每个成熟的软件项目都有自己的配置文件:.gitignore、package.json、pyproject.toml、.eslintrc。这些文件记录项目级约定,供每位贡献者遵守。CLAUDE.md 是这一家族的新成员——它是用于配置 AI 智能体行为的配置文件。
Claude Code 启动会话时,会先读取项目根目录中的 CLAUDE.md,然后才开始做其他事情。这个文件是你向智能体传达持久化指令、并通过版本控制管理这些指令的渠道。可以把它想成给新承包商的一份工作说明:项目是什么、团队如何协作、有哪些规则。
一份编写得当的 CLAUDE.md
# Project: payments-service

## Architecture
- Python 3.12, FastAPI, SQLAlchemy async
- PostgreSQL 16 via asyncpg
- All async/await — no synchronous DB calls
- Repository pattern: db layer never imported directly into routes

## Code Style
- Black formatting, line-length 88
- Use `from __future__ import annotations`
- Type hints required on all public functions
- No `Any` in type hints unless absolutely justified

## Testing
- pytest with pytest-asyncio
- Run tests with: `make test`
- Preferred: unit tests over integration tests; use `respx` to mock HTTP
- Never use `unittest.mock.patch` — use dependency injection instead

## Workflow
- Always run `make lint && make typecheck` after code changes
- Write failing test first, then implementation
- Commit message format: `type(scope): description` (Conventional Commits)

## Things to Avoid
- Do NOT use synchronous SQLAlchemy sessions
- Do NOT add new dependencies without checking with me first
- Do NOT suppress type errors with `# type: ignore`
请注意,这个文件不应该是什么:它不是 Python 教程,也不是罗列每个 Python 开发者都已熟知的通用约定。它只记录 Claude 原本需要自行推断、而且可能推断错误的项目专属规则。
/init 命令会分析代码库并生成一份 CLAUDE.md 初稿。你可以以此为基础,再毫不留情地删减内容。
子智能体编排:多智能体模式
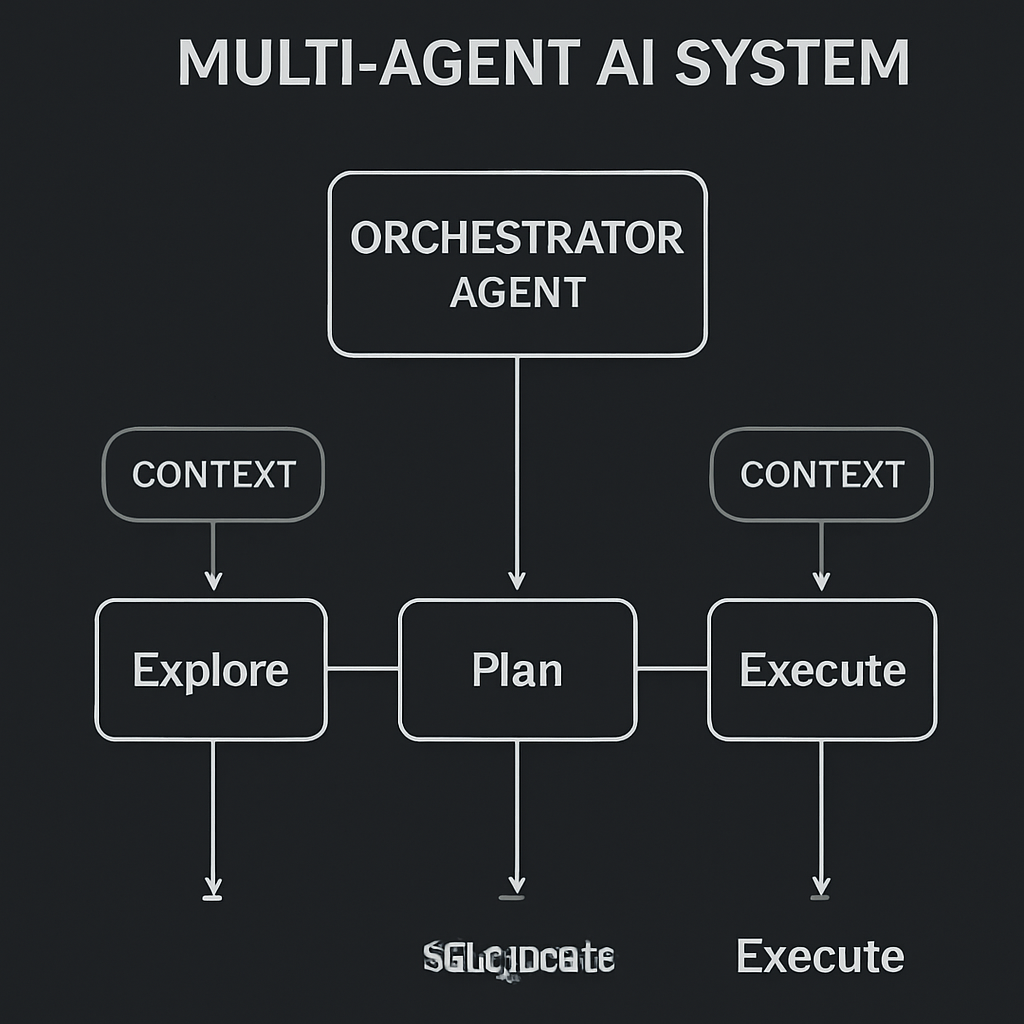
Claude Code 最强大、却尚未被充分使用的功能之一,是原生支持子智能体编排。子智能体是彼此独立的 Claude 会话,各自拥有独立的上下文窗口、系统提示、工具权限限制,也可以选择不同的模型。
内置子智能体
Claude Code 内置了三种会自动启用的子智能体:
| 子智能体 | 模型 | 工具 | 用途 |
|---|---|---|---|
| Explore | Claude Haiku(快速、低成本) | 只读 | 搜索代码库,避免主上下文被搜索内容占满 |
| Plan | 继承父会话模型 | 只读 | Plan Mode 的调研阶段 |
| General-purpose | 继承父会话模型 | 全部工具 | 处理需要修改内容的复杂多步骤任务 |
Explore 智能体尤其值得深入了解。当你要求 Claude“先弄清楚认证流程如何运作,再修复这个 Bug”时,Claude 可以直接在主会话中读取文件,但这样一来,可能无关的搜索结果就会消耗主会话的上下文额度。另一种做法是启动 Explore 子智能体:它读取所需文件、形成理解,再把摘要返回主会话。原始文件内容不会进入主会话上下文。
编写自定义子智能体
自定义子智能体以带有 YAML frontmatter 的 Markdown 文件定义。下面是一个安全审查子智能体示例:
---
name: security-reviewer
description: Reviews code changes for security vulnerabilities, injection risks,
  auth issues, and secrets exposure. Invoke when reviewing PRs or new endpoints.
model: claude-opus-4-7
tools:
  - Read
  - Bash(git diff, git log)
permission_mode: plan
---

You are a senior application security engineer. When invoked, you:
1. Run `git diff HEAD~1` to see recent changes
2. Check for SQL injection, XSS, SSRF, and auth bypass patterns
3. Scan for hardcoded secrets or credentials
4. Report findings with severity (Critical/High/Medium/Low) and remediation

Be concise. Only report genuine issues, not style nitpicks.
将此文件保存为项目中的 .claude/agents/security-reviewer.md。当上下文显示需要安全审查时,Claude 会自动调用它;你也可以明确指定调用。
多智能体并行模式
处理大型重构时,可以将工作拆分后交给多个子智能体并行执行:
# In your main Claude Code session:
# "Split this refactor into 3 parallel tasks:
#  1. Update all tests to the new API signature
#  2. Update all route handlers
#  3. Update the DB layer
# Spawn one general-purpose agent per task and report when all three complete."
对于规模大、可以拆分的任务,这种模式能显著提升速度,同时让每个子智能体的上下文保持清晰、聚焦。
将 AI 编程智能体接入 CI/CD 流水线
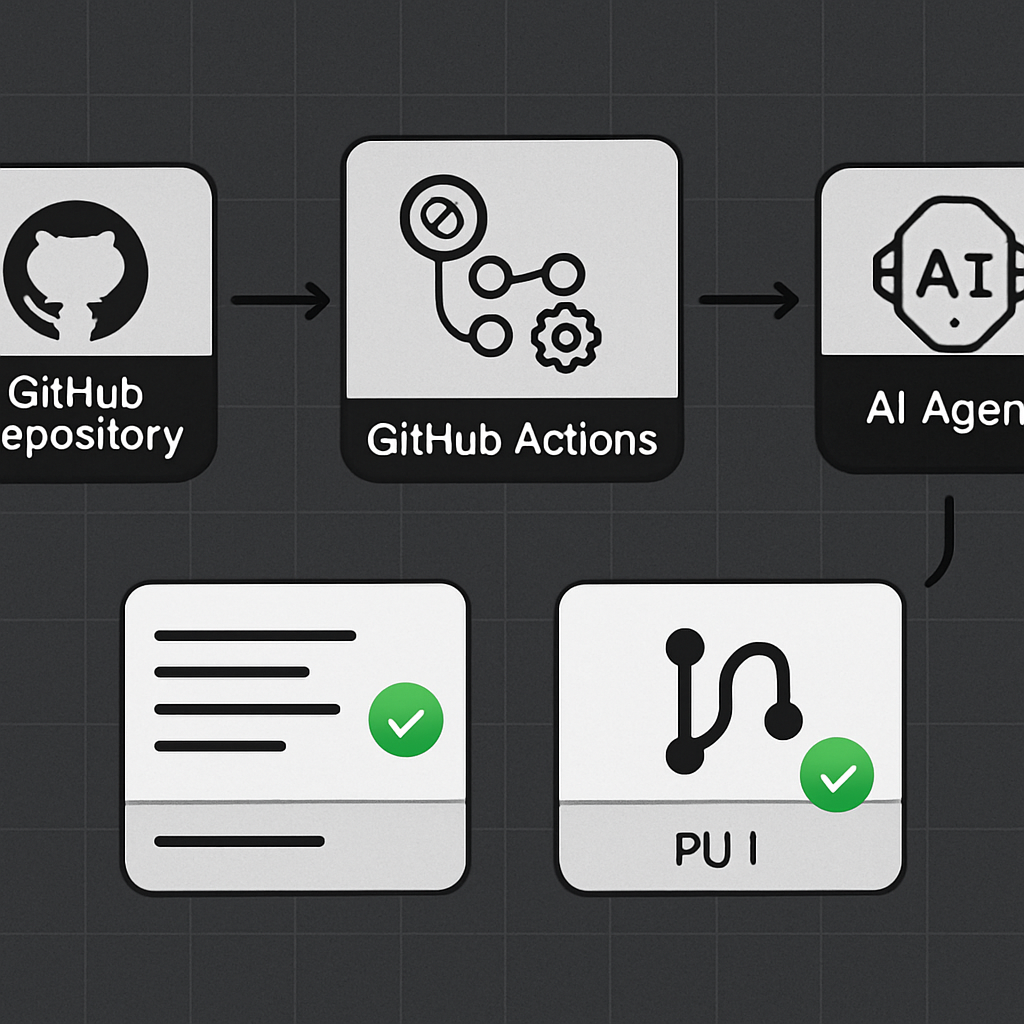
Claude Code 不只是本地开发工具。它提供了面向生产环境的 GitHub Actions 集成,可以实现真正强大的自动化。
配置 Claude Code GitHub Actions
# .github/workflows/claude-code.yml
name: Claude Code Agent

on:
  issue_comment:
    types: [created]
  pull_request_review_comment:
    types: [created]
  issues:
    types: [opened, assigned]

permissions:
  contents: write
  issues: write
  pull-requests: write

jobs:
  claude:
    if: contains(github.event.comment.body, '@claude')
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
        with:
          fetch-depth: 0

      - uses: anthropics/claude-code-action@v1
        with:
          anthropic_api_key: ${{ secrets.ANTHROPIC_API_KEY }}
          claude_args: |
            --model claude-sonnet-4-6
            --max-turns 15
            --append-system-prompt "Follow the conventions in CLAUDE.md strictly. Always run tests before marking a task complete."
使用这套工作流,团队任何成员都可以在 GitHub Issue 中留言:@claude implement the sorting feature described in this issue。之后智能体会自主读取 Issue、探索代码库、实现功能、运行测试套件并创建 Pull Request。
每次提交都自动审查 PR
# .github/workflows/claude-review.yml
name: Automated Code Review

on:
  pull_request:
    types: [opened, synchronize]

jobs:
  review:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4

      - uses: anthropics/claude-code-action@v1
        with:
          anthropic_api_key: ${{ secrets.ANTHROPIC_API_KEY }}
          prompt: |
            Review this PR for:
            1. Logic errors and edge cases
            2. Missing error handling
            3. Performance issues (N+1 queries, unnecessary loops)
            4. Security concerns (injection, auth bypasses, secrets exposure)
            5. Test coverage gaps

            Do NOT comment on style — we have a linter for that.
            Post your review as a PR review with inline comments.
          claude_args: "--model claude-opus-4-7 --max-turns 5"
定时维护智能体
# .github/workflows/daily-maintenance.yml
name: Daily Maintenance Agent

on:
  schedule:
    - cron: "0 6 * * 1-5"  # Weekdays at 6 AM

jobs:
  maintain:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4

      - uses: anthropics/claude-code-action@v1
        with:
          anthropic_api_key: ${{ secrets.ANTHROPIC_API_KEY }}
          prompt: |
            Perform daily maintenance:
            1. Check for dependency security advisories (run: pip-audit or npm audit)
            2. Update any dependencies with only patch version bumps
            3. Run the full test suite to confirm nothing broke
            4. If all tests pass, open a PR titled "chore: automated dependency updates [DATE]"
          claude_args: "--model claude-sonnet-4-6 --max-turns 20"
Token 经济:成本、企业定价与优化
来谈谈成本——许多工程团队都是在这里被打了个措手不及。
截至 2025 年底,Anthropic 企业客户采用固定席位定价,包含较为充足的使用额度。2025 年 11 月,Anthropic 转向按 API Token 用量向企业计费,也就是说,团队在 Claude Code 中消耗的每个 Token 都按公开 API 价格收费。OpenAI 也在 2026 年 4 月对 Codex 做出了相同调整。
Simon Willison 用 ccusage 统计了自己 30 天的用量,发现如果按 API 价格计费,他本应支付 1,199.79 美元;而在 Max 订阅下,他实际只花了 100 美元。大规模使用编程智能体的企业,单个团队每月的账单已经达到四位数乃至五位数。
估算成本
下面是一个用于估算 Claude Code 成本的简易 Python 计算器:
# Claude Sonnet 4.6 approximate pricing
# (verify current rates at anthropic.com/pricing before using in production)
SONNET_INPUT_COST_PER_MTok = 3.00   # $3.00 per million input tokens
SONNET_OUTPUT_COST_PER_MTok = 15.00  # $15.00 per million output tokens

# Opus 4.7 (for complex tasks) — verify this stat before publishing
OPUS_INPUT_COST_PER_MTok = 15.00
OPUS_OUTPUT_COST_PER_MTok = 75.00

def estimate_session_cost(
    avg_context_tokens: int,
    avg_output_tokens: int,
    sessions_per_day: int,
    model: str = "sonnet",
    working_days: int = 22
) -> dict:
    """
    Estimate monthly Claude Code cost for an engineer.

    Args:
        avg_context_tokens: Average input tokens per session
        avg_output_tokens: Average output tokens per session
        sessions_per_day: How many Claude Code sessions per day
        model: "sonnet" or "opus"
        working_days: Working days per month
    """
    if model == "sonnet":
        input_rate = SONNET_INPUT_COST_PER_MTok / 1_000_000
        output_rate = SONNET_OUTPUT_COST_PER_MTok / 1_000_000
    else:
        input_rate = OPUS_INPUT_COST_PER_MTok / 1_000_000
        output_rate = OPUS_OUTPUT_COST_PER_MTok / 1_000_000

    sessions_per_month = sessions_per_day * working_days
    monthly_input_cost = avg_context_tokens * sessions_per_month * input_rate
    monthly_output_cost = avg_output_tokens * sessions_per_month * output_rate
    total = monthly_input_cost + monthly_output_cost

    return {
        "monthly_input_cost": round(monthly_input_cost, 2),
        "monthly_output_cost": round(monthly_output_cost, 2),
        "total_monthly_cost": round(total, 2),
        "sessions_per_month": sessions_per_month,
        "cost_per_session": round(total / sessions_per_month, 4)
    }

# Example: developer running 8 sessions/day on Sonnet
# Each session: ~40K context tokens, ~4K output tokens
result = estimate_session_cost(
    avg_context_tokens=40_000,
    avg_output_tokens=4_000,
    sessions_per_day=8,
    model="sonnet"
)

print(f"Estimated monthly cost: ${result['total_monthly_cost']}")
print(f"Sessions per month:     {result['sessions_per_month']}")
print(f"Cost per session:       ${result['cost_per_session']}")
# Output:
# Estimated monthly cost: $323.84
# Sessions per month:     176
# Cost per session:       $1.84
成本优化策略
- 为任务选择合适的模型。常规实现任务用 Sonnet;复杂的架构推理留给 Opus;只负责探索的子智能体可用 Haiku。仅靠模型路由就能将成本降低 60%–80%。
- 在 CI/CD 中限制最大轮数。在自动化流水线里设置
--max-turns 10,防止智能体面对模糊任务时陷入无限循环。 - 认真打磨 CLAUDE.md。准确的 CLAUDE.md 能减少反复纠错。每减少一次迭代,大约就能节省 1 万个 Token。
- 把探索任务交给 Haiku 子智能体。将代码库搜索委派给由 Haiku 驱动的 Explore 子智能体,成本约为 Sonnet 的 0.25 倍;它只把摘要返回主会话。
- 设定团队预算和告警。使用 Anthropic Console 的用量监控,为各团队设置每月额度上限和告警阈值,别等到账单来了才发现超支。
改变一切的两个拐点
要理解 AI 编程智能体为什么是在现在而非两年前 ChatGPT 发布时迅速普及,就需要了解两个具体的拐点。
2025 年 11 月:能力拐点
2025 年 11 月之前,基于大语言模型的编程工具在生成代码方面表现亮眼,但在自主完成工程任务方面并不可靠。它们会捏造 API、忘记对话早期提出的约束,也无法在没有人工介入的情况下从工具错误中恢复。
2025 年 11 月,GPT-5.1 与 Anthropic 的 Opus 4.5 相继发布。这是第一批与各自智能体运行框架配合后,能够可靠地端到端完成真实多步骤工程任务的模型。提升主要体现在长上下文连贯性、工具使用可靠性和错误恢复推理能力上。实际结果是:工程师开始愿意信任其输出,并将其纳入生产工作流。
随后六个月,采用速度持续加快——Simon Willison 将其称为“十一月拐点”。
2026 年 4 月:营收拐点
2026 年 4 月出现了另一类拐点:商业模式终于成形。Anthropic 和 OpenAI 都推出了新的前沿模型(Opus 4.7、GPT-5.5),API 价格更高;与此同时,两家公司也将企业客户锁定在按 Token 用量、依照这些价格计费的模式中。
此前一直在较宽松的固定费率合约下使用编程智能体的企业客户,续约时发现自己必须按完整 API 价格付费。Uber 的预算故事、微软取消 Claude Code 许可,以及 Anthropic 即将盈利,都可以追溯到这一项结构性变化。
对于工程师来说,营收拐点传达了一个明确的信号:这些工具创造了足够可量化的价值,客户愿意为它们支付高昂的 API 价格。这与“这是个很吸引人的演示”有着根本区别。
面向智能体优先的工作流进行工程设计
采用 AI 编程智能体不只是安装软件,还意味着重新设计工作流。以下做法一再被证明能够带来更好的结果:
1. 先设计可验证的提示
# Weak prompt — no verifiable success criterion
"Fix the login bug"

# Strong prompt — autonomous feedback loop possible
"Users report login fails after session timeout.
The issue is in src/auth/. Check token refresh logic.
Write a failing test reproducing the issue, fix it, and confirm
the test passes. Cover: expired tokens, near-expiry refresh,
and concurrent refresh requests."
两种提示的差别,关键在于智能体能不能自行闭合反馈循环。可验证的标准能让智能体循环自主运行,直至任务完成。
2. 先探索,再规划,最后编码(不要一上来就写代码)
不要急着让 Claude 马上开始编码。使用 Plan Mode(在提示前加上 /plan),先强制进行只读探索与规划,再写入任何文件。单是这一做法,就能避免最常见的失败情况:Claude 用正确的代码解决了错误的问题。
3. 采用测试驱动的智能体工作流
在实现之前,先写(或让 Claude 写)一个会失败的测试。这样就为智能体设定了明确、自动化的验证关卡。整个循环如下:
write failing test → run test (RED) → implement → run test (GREEN) → commit
这与传统的 TDD 类似,只不过测试和实现都由智能体驱动。
4. 将大型任务拆分到多个会话中
如果任务预计需要超过约 30 分钟,就应在开始之前明确拆分:
"Before we start, decompose this feature into the minimum set of
independent tasks, ordered by dependency. I want to run each
as a separate Claude Code session."
这样可以避免任务中途上下文溢出,也能自然形成检查点,方便从检查点重新开始。
未来展望:AI 编程智能体将走向何方
每月 12.5 亿美元的推理账单不仅是一个财务数据点,更是算力投资流向的方向性信号。以下几条趋势值得密切关注:
专用模型芯片。通用 GPU 从根本上说并不适合高效处理推理负载。随着模型架构趋于稳定,可以预期会出现针对推理优化的 ASIC,类似 TPU 在训练领域发挥的作用。每 Token 成本和延迟将出现阶跃式下降,让运行编程智能体变得显著便宜。
面向大型工程任务的多智能体集群。Claude Code 目前的子智能体编排模式,只是“工程智能体集群”的早期预览:一个高层编排器拆解大型功能,把任务并行分派给数十个专业智能体,再整合它们的结果。当前瓶颈在于编排可靠性与上下文同步,而这两方面都在积极研发中。
扩展到软件工程以外的领域。编程智能体率先成功,是因为编译、测试、Lint 这一反馈闭环格外紧密且客观。可以预期,类似的智能体也会进入数据分析、财务建模、基础设施配置,以及其他具备结构化验证标准的知识工作领域。
双向模型蒸馏。随着企业部署模式成熟,来自生产环境使用的反馈闭环将推动微调后的领域专用模型变体不断发展——这些模型会更小、更便宜、更快,并专门适配特定代码库或工程领域。
结语
AI 编程智能体并不是在现有工作方式上简单叠加的生产力倍增器,而是一种不同的范式。在这种范式下,开发者的主要产出将从编写代码转向设定目标、定义验收标准,以及审查自主工程协作者的工作成果。
支撑这一转变的架构——智能体循环、工具编排、上下文窗口管理、子智能体并行以及 CI/CD 集成——都可以学习并掌握。现在就投入时间理解这些系统的工程师,能够在技术逐渐成熟的过程中持续获得复利式回报。
到 2027 年,Uber 的 25% 代码提交占比可能会显得微不足道。能够理解这套架构、聪明地管理成本,并构建稳健的智能体优先工作流的团队,会最先走到那一步。
准备好开始了吗?今天就从待办事项中挑一个任务。为项目写一份 CLAUDE.md,先写一个会失败的测试,再把任务交给智能体,看看这个循环会把你带到哪里。
趋势话题来源:Hacker News、Substack 和 TechCrunch|2026 年 5 月 28 日|重点关键词:AI 编程智能体|预计阅读时间:14 分钟
你是否已在生产工作流中部署 AI 编程智能体?你发现哪些模式最有效?欢迎在下方评论区分享经验。